
Là, immédiatement : lancez un BIA pour lister vos fonctions critiques, définissez un RTO et un RPO par service, appliquez la règle 3-2-1 avec une copie hors ligne, puis programmez des tests réguliers de restauration. Le reste du travail consiste à documenter des runbooks activables par un tiers et à préparer un plan de remédiation E3R pour les incidents cyber. Ce socle suffit à transformer un plan de reprise informatique théorique en outil réellement exploitable en crise.
En bref:
- Le choix du site de reprise doit être aligné sur les RTO et RPO fixés, de site chaud pour des délais très courts à site froid ou infonuagique pour des délais plus longs.
- La règle 3-2-1 impose trois copies de sauvegarde, sur deux supports différents, avec une copie hors site et hors ligne, pour garantir la résilience face aux rançongiciels.
- Tester régulièrement le plan de reprise en simulant des scénarios réels permet d’identifier les écarts et d’ajuster les procédures en conséquence.
- La documentation des runbooks doit être autonome, claire et actionnable pour une exécution par un tiers sans connaissance préalable de l’organisation.
- La boucle d’amélioration continue du PRA passe par la mesure des performances lors des exercices, notamment le respect des délais de restauration et la complétude des données récupérées.
Table des matières
- Réaliser un inventaire et une analyse d’impact métier (BIA)
- Fixer des objectifs RTO et RPO réellement alignés sur le métier
- Choisir entre site chaud, site tiède, site froid et reprise infonuagique
- Sauvegardes et règle 3-2-1 : la base de toute restauration fiable
- Le cadre E3R pour la remédiation des incidents cyber graves
- Tester le PRA : exercices ciblés, simulations complètes et boucle d’apprentissage
- Gouvernance et documentation : qui fait quoi, et où trouver les runbooks
- Checklist opérationnelle des 72 premières heures
- Pourquoi le PRA doit rester une boucle continue, pas un document figé
- Se former pour internaliser la capacité de reprise et de remédiation
- Sources
- Questions fréquentes
Réaliser un inventaire et une analyse d’impact métier (BIA)
Le bilan d’impact métier commence par une question simple : qu’est-ce qui, si ça tombe, arrête l’entreprise ? Il faut y associer les responsables métiers, les administrateurs systèmes et les fournisseurs critiques, car chacun détient une partie de l’information sur les dépendances réelles.
Pour chaque application ou donnée, une fiche d’actif doit recenser son propriétaire, ses interdépendances techniques, ses obligations réglementaires et son impact financier en cas d’indisponibilité. Trois indicateurs structurent ensuite la priorisation :
- Le niveau de sécurité et de sensibilité des données traitées.
- Les pertes financières estimées par heure ou par jour d’interruption.
- Les obligations légales ou contractuelles liées au service (délais imposés, clauses SLA client).
Le livrable attendu est double : une matrice de criticité classant chaque fonction et une cartographie des dépendances entre applications, infrastructures et prestataires externes.
Fixer des objectifs RTO et RPO réellement alignés sur le métier
Le RTO (délai de reprise acceptable) et le RPO (perte de données tolérable) ne se choisissent pas dans l’abstrait : ils traduisent une exigence métier en paramètre technique. Une messagerie critique pour la relation client peut exiger un RTO de quelques heures, tandis qu’un outil de reporting interne tolère une journée complète d’indisponibilité.
La méthode consiste à :
- Interroger chaque responsable métier sur le délai maximal supportable avant impact grave.
- Convertir cette réponse en configuration technique : fréquence de sauvegarde, réplication, redondance.
- Faire approuver formellement les couples RTO/RPO par la direction, car ils engagent un budget.
Un article interne sur la priorisation des applications détaille comment ces délais se répercutent sur l’organisation opérationnelle. L’ENISA rappelle que ces objectifs doivent figurer, consolidés, dans le plan de continuité informatique lui-même, avec les rôles et procédures d’invocation associés.
Choisir entre site chaud, site tiède, site froid et reprise infonuagique
Le choix d’une stratégie de reprise dépend directement des RTO/RPO fixés à l’étape précédente, pas l’inverse. Quatre options structurent la réflexion :
- Le site chaud duplique en temps réel l’infrastructure de production et permet une reprise en quelques minutes, au prix d’un investissement permanent élevé.
- Le site tiède maintient une infrastructure partielle, prête à être activée en quelques heures, un compromis fréquent pour les services à criticité moyenne.
- Le site froid conserve uniquement l’espace et l’alimentation nécessaires, sans matériel actif : la reprise prend plusieurs jours mais le coût de possession reste faible.
- La reprise infonuagique exploite des capacités à la demande chez un fournisseur cloud, avec un RTO ajustable selon le niveau de service souscrit.
Le critère de choix combine le RTO exigé, le budget disponible et les compétences internes pour opérer la solution. Avant de signer, vérifiez les clauses contractuelles du fournisseur : garanties de disponibilité, délais d’activation réels et responsabilités en cas de défaillance du prestataire lui-même.
Sauvegardes et règle 3-2-1 : la base de toute restauration fiable
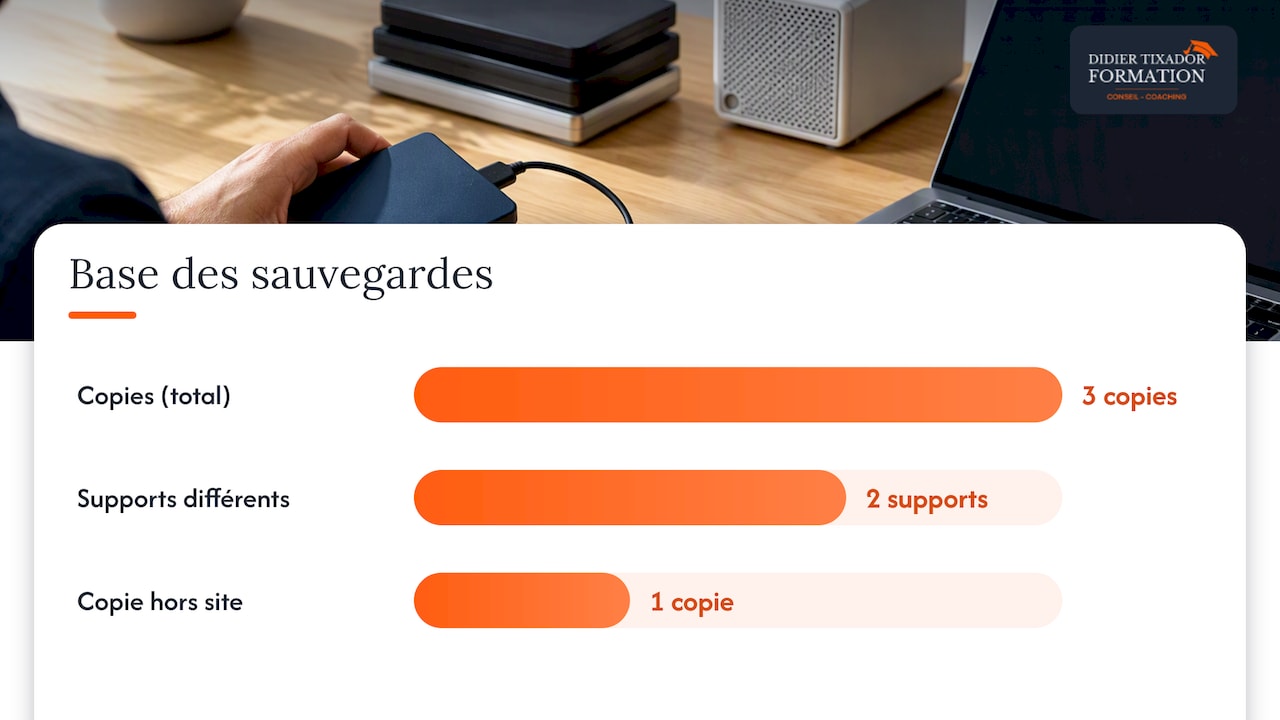
Aucun plan de reprise informatique ne tient sans une stratégie de sauvegarde solide. La règle 3-2-1 reste la référence du secteur : trois copies des données, sur deux supports différents, dont une copie hors site et hors ligne, isolée du réseau de production.
Cette isolation hors ligne est ce qui protège contre un rançongiciel capable de chiffrer les sauvegardes connectées. Concrètement :
- Conservez au moins une copie sur un support déconnecté du réseau ou dans un coffre immuable qui empêche toute modification rétroactive.
- Chiffrez systématiquement les sauvegardes, y compris celles stockées hors site.
- Testez la restauration à intervalle régulier, pas seulement la sauvegarde elle-même, pour vérifier l’intégrité des données récupérées.
Les délais de restauration après un rançongiciel peuvent dépasser plusieurs dizaines d’heures, selon l’ENISA, ce qui justifie de fixer des RTO réalistes plutôt qu’optimistes. La CNIL recommande par ailleurs de prévoir un fonctionnement dégradé et de ne jamais relâcher le niveau de protection des données pendant la phase de reprise.
Le cadre E3R pour la remédiation des incidents cyber graves
Un plan de reprise classique suppose une panne matérielle ou un sinistre physique. Un incident cyber grave, lui, exige une étape supplémentaire avant toute restauration : la remédiation. Le guide opérationnel gouvernemental sur la cyberattaque et la remédiation structure cette phase autour du cadre E3R.
- Éviction : couper l’accès de l’attaquant au système d’information, souvent en isolant les segments réseau compromis.
- Éradication : supprimer toute trace de persistance (comptes créés, scripts, portes dérobées) avant de reconstruire quoi que ce soit.
- Reconstruction : rebâtir les systèmes sur une infrastructure propre, jamais sur l’environnement compromis.
Chaque objectif stratégique doit se décliner en actions techniques datées et attribuées à un responsable nommé. La précaution la plus souvent négligée : ne jamais restaurer depuis une sauvegarde ou un serveur potentiellement infecté. La reconstruction utilise des images système connues et non compromises, sur du matériel isolé du réseau d’origine.
Conseil de pro : avant toute reconstruction, faites analyser un échantillon des sauvegardes candidates par votre équipe sécurité pour écarter tout risque de réinfection.
Tester le PRA : exercices ciblés, simulations complètes et boucle d’apprentissage
Un plan non testé est une hypothèse, pas un plan. La méthode se construit en trois temps :
- Programmez des exercices ciblés sur un composant critique à la fois (une base de données, une application métier) pour limiter la perturbation opérationnelle.
- Organisez une simulation complète au moins une fois par an, incluant la communication de crise et l’activation réelle du site de secours.
- Après chaque exercice, documentez les écarts entre le scénario prévu et l’exécution réelle, puis mettez à jour le plan en conséquence.
Les critères de réussite doivent être mesurables : temps réel de restauration comparé au RTO cible, complétude des données restaurées comparée au RPO, et capacité de l’équipe à suivre le runbook sans improvisation. La CNIL insiste sur l’intérêt des tests ciblés fréquents, complétés par des exercices périodiques plus larges, pour limiter l’impact sur la production tout en maintenant la préparation à jour.
Gouvernance et documentation : qui fait quoi, et où trouver les runbooks
Un PRA n’a de valeur que si un tiers peut l’exécuter sans connaître l’historique de l’entreprise. La documentation doit donc rester autonome et actionnable, pas seulement conforme sur le papier.
-
La procédure d’invocation précise qui a l’autorité de déclencher le plan, avec au moins un suppléant nommé pour chaque rôle clé.
-
La liste de contacts inclut les coordonnées directes des intervenants internes, des prestataires critiques et des autorités compétentes.
-
Le modèle de runbook reste minimaliste : étapes numérotées, commandes exactes, captures d’écran si utile, sans jargon interne non expliqué.
-
Un processus de gestion des changements garantit que toute modification d’infrastructure déclenche une revue du PRA correspondant.
Cette exigence d’autonomie documentaire rejoint une pratique reconnue du secteur : un playbook de reprise doit rester exécutable par un spécialiste externe qui ne connaît ni l’organisation ni les habitudes internes de l’équipe.
Checklist opérationnelle des 72 premières heures
Les premières heures d’un incident déterminent souvent l’ampleur des dégâts. Voici la séquence à suivre :
- Heure 0 à 4 : isoler les systèmes touchés, préserver les preuves, activer la cellule de crise.
- Heure 4 à 24 : vérifier l’intégrité des sauvegardes disponibles, informer les parties prenantes internes et, si nécessaire, les autorités compétentes.
- Jour 2 : lancer la restauration ou basculer vers la remédiation E3R si une compromission active est confirmée.
- Jour 3 : valider le fonctionnement des services restaurés et documenter les écarts pour la revue post-incident.
| Fenêtre | Action prioritaire | Décision clé |
|---|---|---|
| 0 à 4 heures | Isolation et préservation des preuves | Activer ou non la cellule de crise |
| 4 à 24 heures | Vérification des sauvegardes | Restaurer ou basculer en remédiation |
| Jour 2 | Restauration ou éradication | Confirmer l’absence de persistance |
| Jour 3 | Validation des services | Clore la phase d’urgence |
Ce format se prête à l’impression ou à l’intégration dans un outil de gestion de crise, à condition de le personnaliser avec les contacts et systèmes réels de l’organisation.
Pourquoi le PRA doit rester une boucle continue, pas un document figé
Le plus grand risque n’est pas l’absence de plan de reprise informatique, c’est le plan rédigé une fois puis oublié. La remédiation cyber, la continuité d’activité et la reprise informatique convergent vers un même objectif : réduire le temps entre l’incident et le retour à un fonctionnement normal, sans réintroduire la faille initiale.
La priorité pour 2026 n’est pas d’ajouter des outils, mais d’automatiser les tests de restauration et de mesurer deux indicateurs simples : le RTO réel constaté lors des exercices et le taux de complétude des données restaurées. Un plan qui n’est jamais mesuré n’est jamais amélioré.
— Didier Tixador
Se former pour internaliser la capacité de reprise et de remédiation
Construire un plan de reprise informatique solide demande des compétences transverses : analyse de risque, cybersécurité, gestion de crise et conduite du changement. Des modules en présentiel, distanciel ou e-learning aident les équipes à structurer ces compétences autour de cadres de décision plutôt que d’accumuler des outils.
Un accompagnement en transformation digitale pour entreprises ou un coaching personnalisé permet d’adapter la méthode à la réalité opérationnelle de votre structure. La première étape reste souvent un audit initial pour identifier les priorités avant de choisir un format de formation adapté au catalogue complet des formations disponibles.
Sources
ANSSI et ENISA détaillent la méthodologie de remédiation, la CNIL encadre la continuité des données personnelles, et la référence académique fixe la norme 3-2-1.
- 3-2-1 backup rule (industry standard)
- Guide ope9rationnel : cyberattaques et reme9diation (Volet ope9rationnel)
- CNIL : Se9curite9 : Pre9voir la continuite9 et la reprise d’activite9
Questions fréquentes
Quelle est la différence entre le PCA et le PRA ?
Le plan de continuité d’activité (PCA) couvre l’ensemble de l’organisation, y compris les processus humains et logistiques, tandis que le plan de reprise d’activité (PRA) se concentre sur la remise en service de l’infrastructure informatique après un sinistre. Le PRA est souvent un sous-ensemble technique du PCA.
Comment rédiger un PCA ?
Un PCA se construit à partir d’un bilan d’impact métier qui identifie les fonctions critiques, puis fixe des objectifs de reprise réalistes et documente les procédures d’activation avec les rôles de chaque intervenant. L’ENISA recommande d’y intégrer scénarios de dégâtement et plans de tests dès la conception.
C’est quoi un PRA en informatique ?
Le plan de reprise d’activité informatique décrit les procédures techniques permettant de restaurer les systèmes, applications et données après une panne, un sinistre ou une cyberattaque. Il s’appuie sur des objectifs de délai (RTO) et de perte de données (RPO) définis pour chaque service critique.
Qu’est-ce qu’un plan de continuité informatique ?
Un plan de continuité informatique regroupe les mesures techniques et organisationnelles qui maintiennent ou rétablissent rapidement les services numériques essentiels après une interruption. Il inclut l’architecture de secours, les rôles des intervenants et les procédures de test recommandées par l’ENISA.